人工智能基础软件开发 从工具链到工程化实践的演进
引言
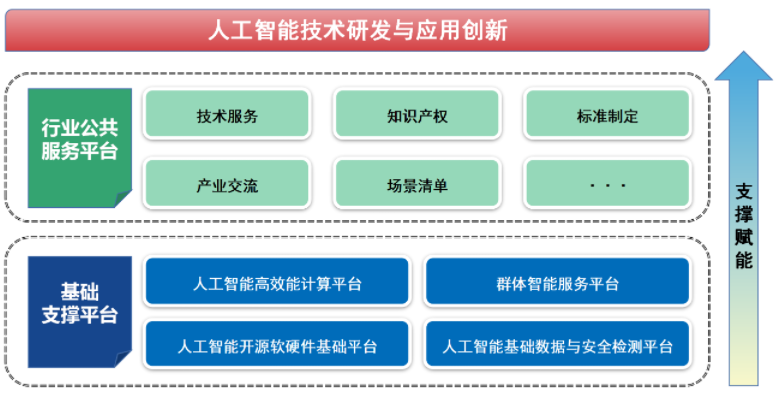
人工智能基础软件是支撑AI模型研发、训练、部署与运维的底层技术栈,涵盖深度学习框架、编译器、算子库、分布式训练系统、推理引擎以及MLOps工具链等核心组件。随着大模型时代的到来,AI基础软件正从「可用」向「高效、可信、易用」演进。InfoQ与极客邦长期关注这一领域的技术传播与创新实践,本文将从技术架构、关键挑战与工程化趋势三个维度展开分析。
一、AI基础软件的技术分层
AI基础软件可以划分为四个层次:
1. 计算引擎层:以PyTorch、TensorFlow、PaddlePaddle、MindSpore为代表的深度学习框架,负责计算图构建、自动微分与设备调度。近年来的趋势是「编译化」——通过TorchDynamo、TVM、XLA等技术将动态图捕获为静态图进行优化,在保持易用性的同时提升执行效率。
2. 算子与通信层:cuDNN、oneDNN等算子库提供高性能底层实现;NCCL、RCCL等通信库支撑多卡多机分布式训练。大模型训练对集合通信的带宽与延迟提出了极高要求,通信与计算的重叠优化成为关键课题。
3. 推理与部署层:TensorRT、ONNX Runtime、vLLM、SGLang等推理引擎负责模型压缩、量化、批处理调度与KV Cache管理。以vLLM的PagedAttention为代表的显存管理技术,显著提升了大模型推理的吞吐能力。
4. MLOps与平台层:涵盖数据管理、实验追踪、模型注册、持续训练与监控。Kubeflow、MLflow、Ray等工具正在与Kubernetes生态深度融合,推动AI工作负载的标准化调度。
二、大模型时代的关键挑战
训练效率与成本:千亿参数模型的训练需要在数千张加速卡上实现近线性扩展。3D并行(数据并行、张量并行、流水线并行)与ZeRO系列显存优化技术成为标配,但并行策略的自动搜索与故障恢复仍是工程难点。
推理性能与显存墙:大模型推理受限于显存带宽与容量。量化(INT8/FP8/FP4)、投机解码、连续批处理等技术组合使用,才能在延迟与吞吐之间取得平衡。
异构硬件适配:国产AI芯片与英伟达GPU并存,框架层需要抽象出统一的设备后端接口,算子库需要针对不同架构做定制优化,这对软件栈的模块化设计提出了更高要求。
可信与可观测:模型行为监控、数据漂移检测、推理链路追踪正在成为生产环境的必选项,AI基础软件需要原生集成可观测能力。
三、工程化实践趋势
编译与运行时融合:以torch.compile、TVM Unity为代表的「框架+编译器」协同设计,正在模糊训练与推理的边界,实现一次编写、多端部署。
AI与云原生深度结合:Ray on Kubernetes、Volcano调度器、GPU共享与拓扑感知调度,使AI工作负载获得与微服务同等的弹性与可运维性。
开源协同与标准建设:ONNX作为模型互操作标准持续演进,OpenXLA、OpenLLM等社区项目推动了跨厂商的协作。国内开源社区如PaddlePaddle、MindSpore也在积极参与国际标准制定。
端到端工具链整合:从数据标注、微调、评测到上线监控的一体化平台逐渐成熟,降低AI应用落地的门槛。
##
人工智能基础软件是AI产业的「操作系统」,其成熟度直接决定了模型创新的速度与落地的广度。面向高效能编译、异构计算抽象、云原生调度与可信工程化将是持续演进的主线。InfoQ与极客邦将继续跟踪这一领域的技术突破与最佳实践,促进开发者之间的知识传播与协作创新。
如若转载,请注明出处:http://www.wogjfts.com/product/10.html
更新时间:2026-10-28 19:26:07